← Artikler · AI og integrasjoner
Hva er Jev? TypeSafes System One-modell i produksjon
Hva er Jev? TypeSafes System One-modell tar beslutninger i stedet for tekst. Vi satte den i produksjon på nettsmed.no, og her er tallene vi målte.
 Sindre Fjellestad · oppdatert · 9 min lesing
I denne artikkelen (9)
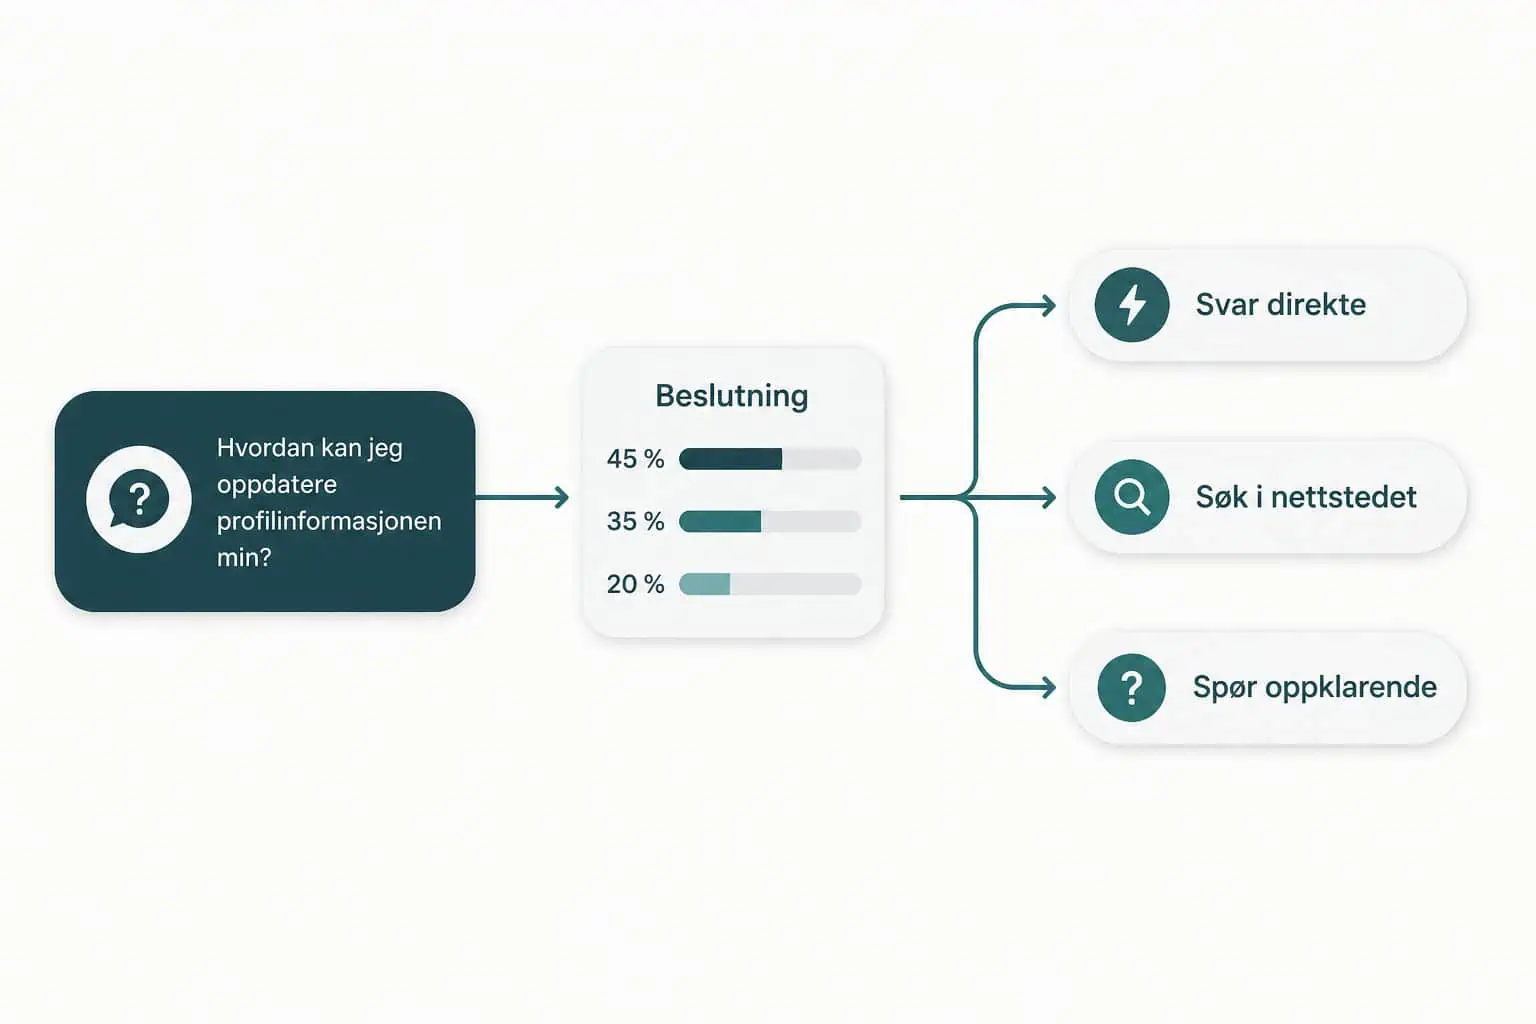
Hva er Jev? Det er TypeSafe AIs første «System One»-modell, og den skriver ikke tekst. Du gir den en tilstand og et typet spørsmål, og den svarer med et valg, sannsynligheter og en confidence-score. Vi satte den i produksjon foran AI-søket på vår egen nettside i september 2026, og denne artikkelen er tallene vi målte — ikke en oversettelse av lanseringsbloggen.
Hva er Jev, kort fortalt
Hva er Jev i én setning: en beslutningsmodell som tar imot ustrukturert tilstand og returnerer en typet, sannsynlighetsvektet avgjørelse.
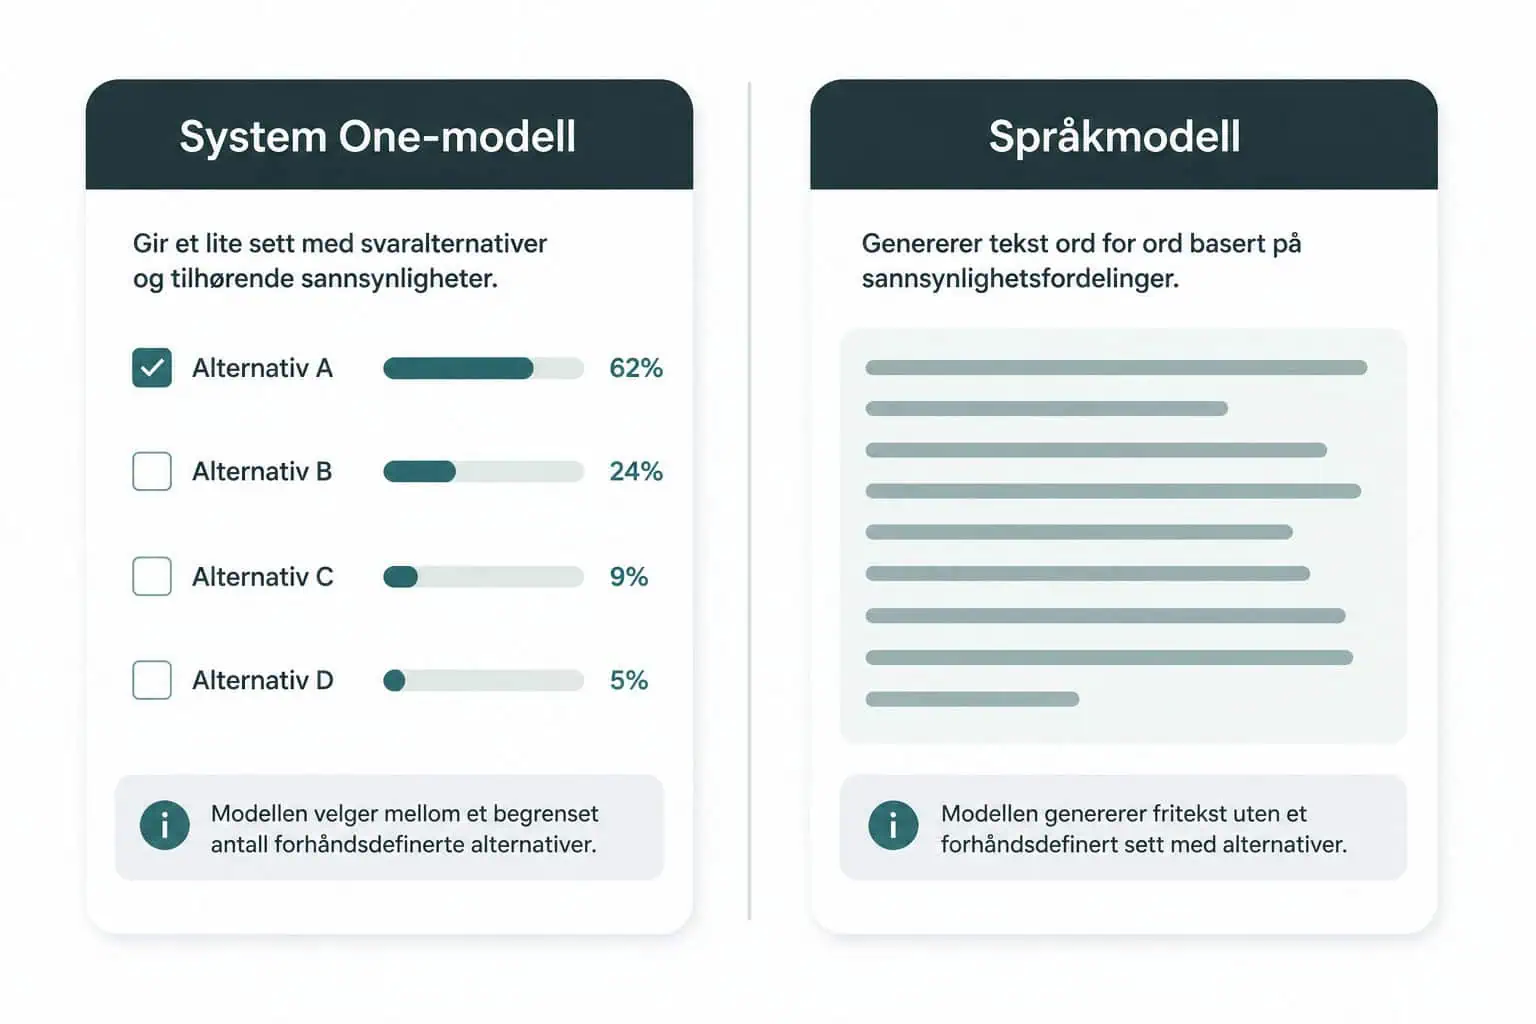
Vanlige språkmodeller er bygget for å produsere tekst et menneske skal lese. Når du trenger en vurdering som koden din skal bruke, oppstår et misforhold: du presser et tekstgenererende system til å skrive ut noe strukturert, og parser deg tilbake til en verdi du kan stole på. Jev hopper over det mellomleddet. Den gir opp tekstgenerering, og til gjengjeld kan den ikke hallusinere et svar utenfor alternativene du har definert.
TypeSafe AI oppgir at Jev-modellen er opptil to størrelsesordener raskere og billigere enn konvensjonelle språkmodeller på denne typen oppgaver (TypeSafe AI). Den er tilgjengelig via blant annet Vercel AI Gateway og Cloudflare.
Jev er ikke lenger alene. På under to uker etter TypeSafe AIs lansering av System One ble beslutningsmodeller en kategori: OpenAI Decisions API, Liquid AI d1, Perplexity og flere andre fulgte etter. Per oktober 2026 er gjeldende versjon jev-1.13.0 (alias jev-latest i TypeSafes modelldokumentasjon). Har du justert terskler mot en bestemt versjon, pin versjons-ID-en — aliaset flytter seg når en ny release kommer.
System One-modell versus språkmodell
Navnet spiller på Kahnemans skille mellom rask, intuitiv tenkning og langsom, resonnerende tenkning. En System One-modell gjør det første: den tar den raske avgjørelsen, og overlater resonneringen og formuleringen til noe annet.
| System One-modell (Jev) | Språkmodell (LLM) | |
|---|---|---|
| Output | Valg + sannsynligheter + confidence | Tekst |
| Hallusinasjon | Umulig utenfor definerte alternativer | Mulig |
| Typisk latens | Titalls til hundretalls millisekunder | Sekunder |
| Kostnad | $0,042 per 1M input-tokens | Ofte 10–100× høyere |
| Egnet til | Ruting, triage, klassifisering, gating | Svar, sammendrag, samtale |
Det er ikke enten–eller. Hos oss sitter Jev foran språkmodellen og bestemmer hvilken vei spørsmålet skal gå. Modellen som svarer kunden er fortsatt en vanlig språkmodell — se hva Claude AI er for den andre halvdelen av stacken.
Jev vs. OpenAI Decisions API og andre beslutningsmodeller
Kategorien har vokst raskt. Oversikten under er et øyeblikksbilde (oktober 2026) basert på leverandørenes egne sider og Vercels oversikt over beslutningsmodeller. Tall som «slår Jev» er leverandørenes egne påstander — ikke uavhengige benchmarker.
| Modell | Pris (input) | Input | Merknad |
|---|---|---|---|
| Jev (TypeSafe AI) | $0,042 per 1M tokens | Tekst | Output gratis; System One-modell |
| OpenAI Decisions API / gpt-6-luna | $0,10 per 1M tokens | Tekst og bilder | Offentlig beta fra 06.10.2026; output gratis; ZDR og EU-datalagring for kvalifiserte kunder (dokumentasjon) |
| Liquid d1 | Se Liquid | Tekst og bilder | Leverandørens egne tester hevder å matche eller slå Jev på flere oppgaver (Liquid-blogg) |
| Perplexity pplx-decider | Se Perplexity | Tekst og bilder | Åpne vekter; se changelog |
| Laya | Se Vercel AI Gateway | Tekst | Åpne vekter via AI Gateway |
Hvilken du velger, handler mer om dataresidens, bildeinput og om du vil kjøre modellen selv, enn om én «vinner» på alle benchmarker.
Slik bruker vi Jev i produksjon på nettsmed.no
«Spør KI» på nettsmed.no kjørte semantisk søk mot hele nettstedet på hver eneste tur — også når spørsmålet var så enkelt at systemprompten allerede holdt svaret. Det kostet latens og tokens uten å gjøre svaret bedre.
Nå gjør en Jev-modell ett beslutningskall per brukertur, før søk og før språkmodellen, og velger mellom tre ruter:
- prompt_only — svar direkte, hopp over søk i nettstedet
- semantic_search — hent kontekst fra nettstedet først
- ask_clarify — still ett oppklarende spørsmål
En probe mot produksjon 20. september 2026 ga dette:
HTTP/2 200
x-jev-route: prompt_only
x-jev-gated: 0
x-jev-latency-ms: 478
478 millisekunder for avgjørelsen, og turen slapp et semantisk søk den ikke trengte.
I AI SDK (fra ai 7.0.128) heter funksjonen experimental_decide. Eldre navn experimental_evaluate er et utdatert alias, og det som tidligere het «evaluation models» kalles nå «decision models» (Vercel AI Gateway). Via Gateway kan du A/B-teste Jev mot OpenAI Decisions bare ved å bytte modell-ID — samme kall, annen modell (changelog).
Hele ruteren ligger bak et feature-flagg hos oss. Enhver feil — manglende nøkkel, 429, timeout eller ugyldig svar — faller stille tilbake til den gamle pipelinen. En ruter som tar ned chatten når leverandøren har et dårlig minutt, er verre enn ingen ruter.
Confidence-gaten vi måtte legge inn
Åtte av åtte ekte spørsmål rutet riktig i smoke-testen. Det niende var det interessante.
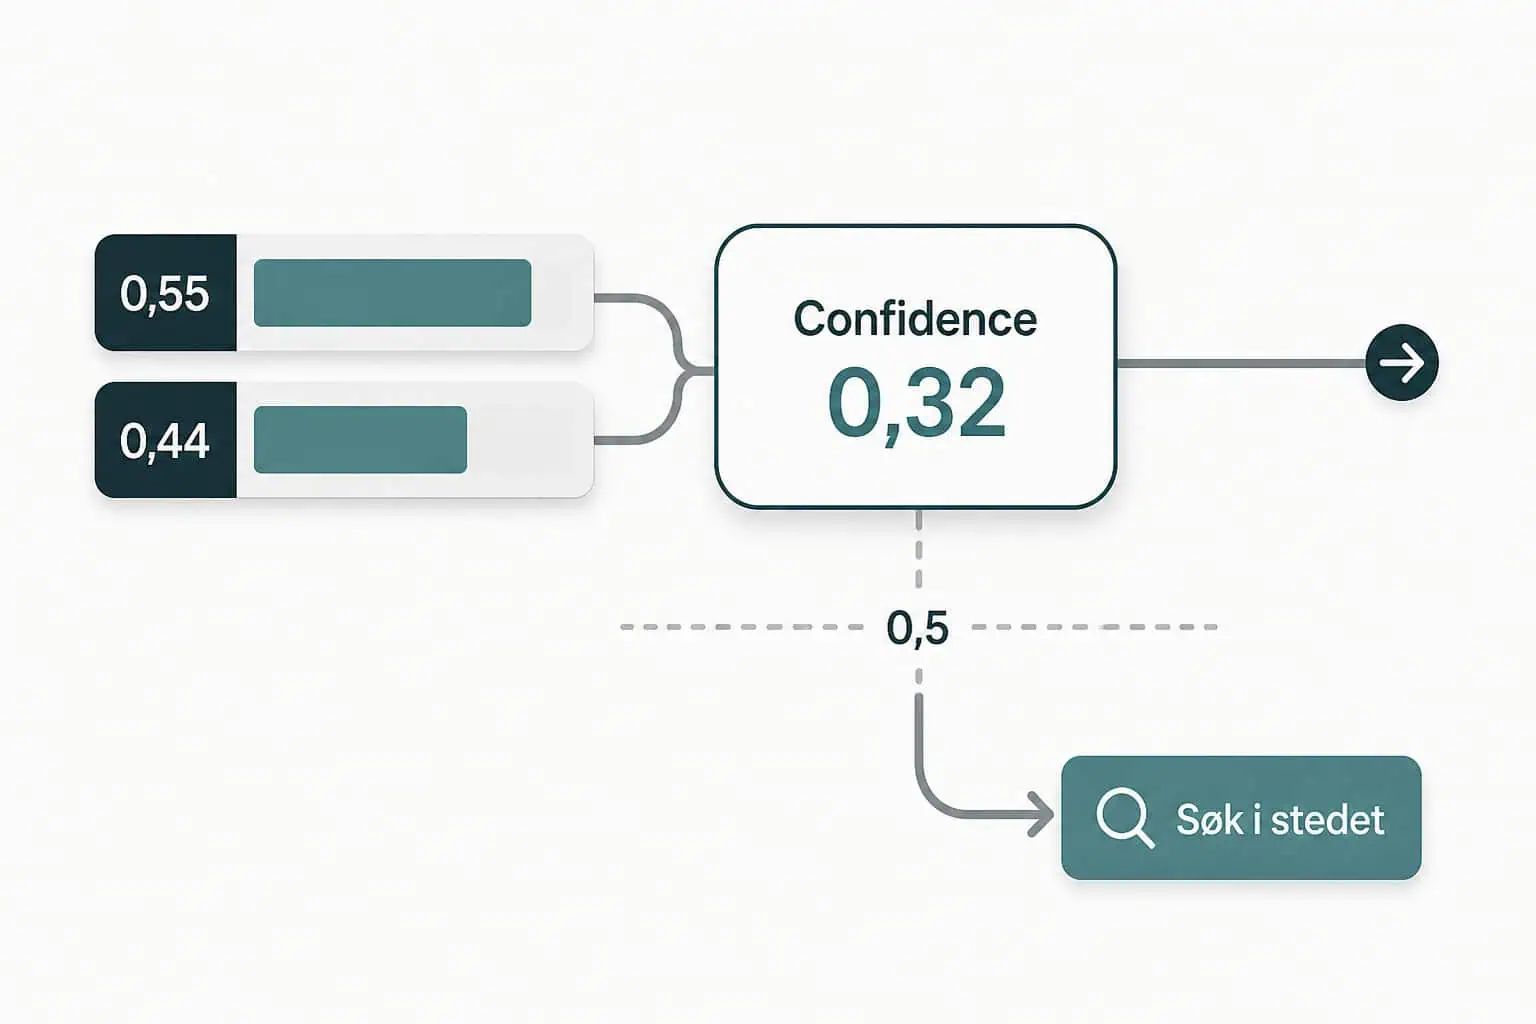
Spørsmålet handlet om GDPR. Jev ga prompt_only 0,55, semantic_search 0,44 — og confidence 0,32. Modellen var i praksis i tvil, men råvalget pekte på «svar direkte». Hadde vi stolt på det, ville chatten svart om personvern uten å slå opp i noe.
Regelen vi la inn: er confidence under 0,5, ikke stol på prompt_only. Er sannsynligheten for semantic_search da minst 0,3, søk. Ellers still et oppklarende spørsmål. Det er ikke en regel vi fant i dokumentasjonen — den kom fra det ene spørsmålet modellen var usikker på.
Dette er samme grep som da vi gjorde et medlemsregister tilgjengelig for AI: gjør oppslaget billig og strukturert i stedet for å la språkmodellen gjette seg frem. Der gikk vi fra fem verktøykall til ett etter at svaret ble slanket fra 290 kB til 11 kB.
Hva Jev ikke kan
Anti-hype først, slik vi også gjør i artikkelen om begrensningene ved AI-agenter:
- Den skriver ikke tekst. Trenger du et svar til et menneske, trenger du fortsatt en språkmodell i tillegg.
- Den er bare så god som alternativene du definerer. Feil valgsett gir feil beslutning, raskt og selvsikkert.
- Confidence er ikke sannhet. Den er et signal du må bygge en regel rundt, slik vi måtte.
- Den fjerner ikke behovet for fallback. Nettverk, kvoter og timeouts finnes fortsatt.
- Den er fersk. Modellen ble lansert i september 2026. Ikke sett den i en kritisk sti uten et flagg du kan slå av.
TypeSafe AI er åpne om svakhetene i jev-1.13 (modell-jaggedness): telling, aritmetikk, datumsammenligning, stor eller støyete tilstand, flerstegs resonnering og adversarial input. Rådet er det samme som vårt: la koden gjøre matematikken, og la Jev-modellen ta den semantiske vurderingen.
Fire bruksområder der en System One-modell er riktig verktøy
- Retrieval-gating. Skal spørsmålet utløse et søk i kunnskapsbasen, eller holder konteksten du allerede har? Det er vårt eget bruksområde, og det som ga tydeligst effekt.
- Modellruting. Send enkle forespørsler til en billig modell og kompliserte til en dyr. Beslutningen koster brøkdelen av forskjellen mellom modellene.
- Henvendelses- og support-triage. Skal denne e-posten besvares automatisk, eskaleres til et menneske, eller vente? Dette er nabolaget til AI-chatbot på nettsiden, men på innkommende henvendelser i stedet for samtale.
- Klassifisering i CRM og saksflyt. Hvilken kategori, hvilken eier, hvilken prioritet. Typede valg med sannsynligheter er lettere å revidere i ettertid enn fritekst en språkmodell skrev.
Fellesnevneren: en avgjørelse koden din skal handle på, med et endelig sett alternativer. Er det en tekst et menneske skal lese, er det feil verktøy.
GDPR og databehandling
For norske virksomheter er dette ofte det avgjørende spørsmålet, ikke latensen.
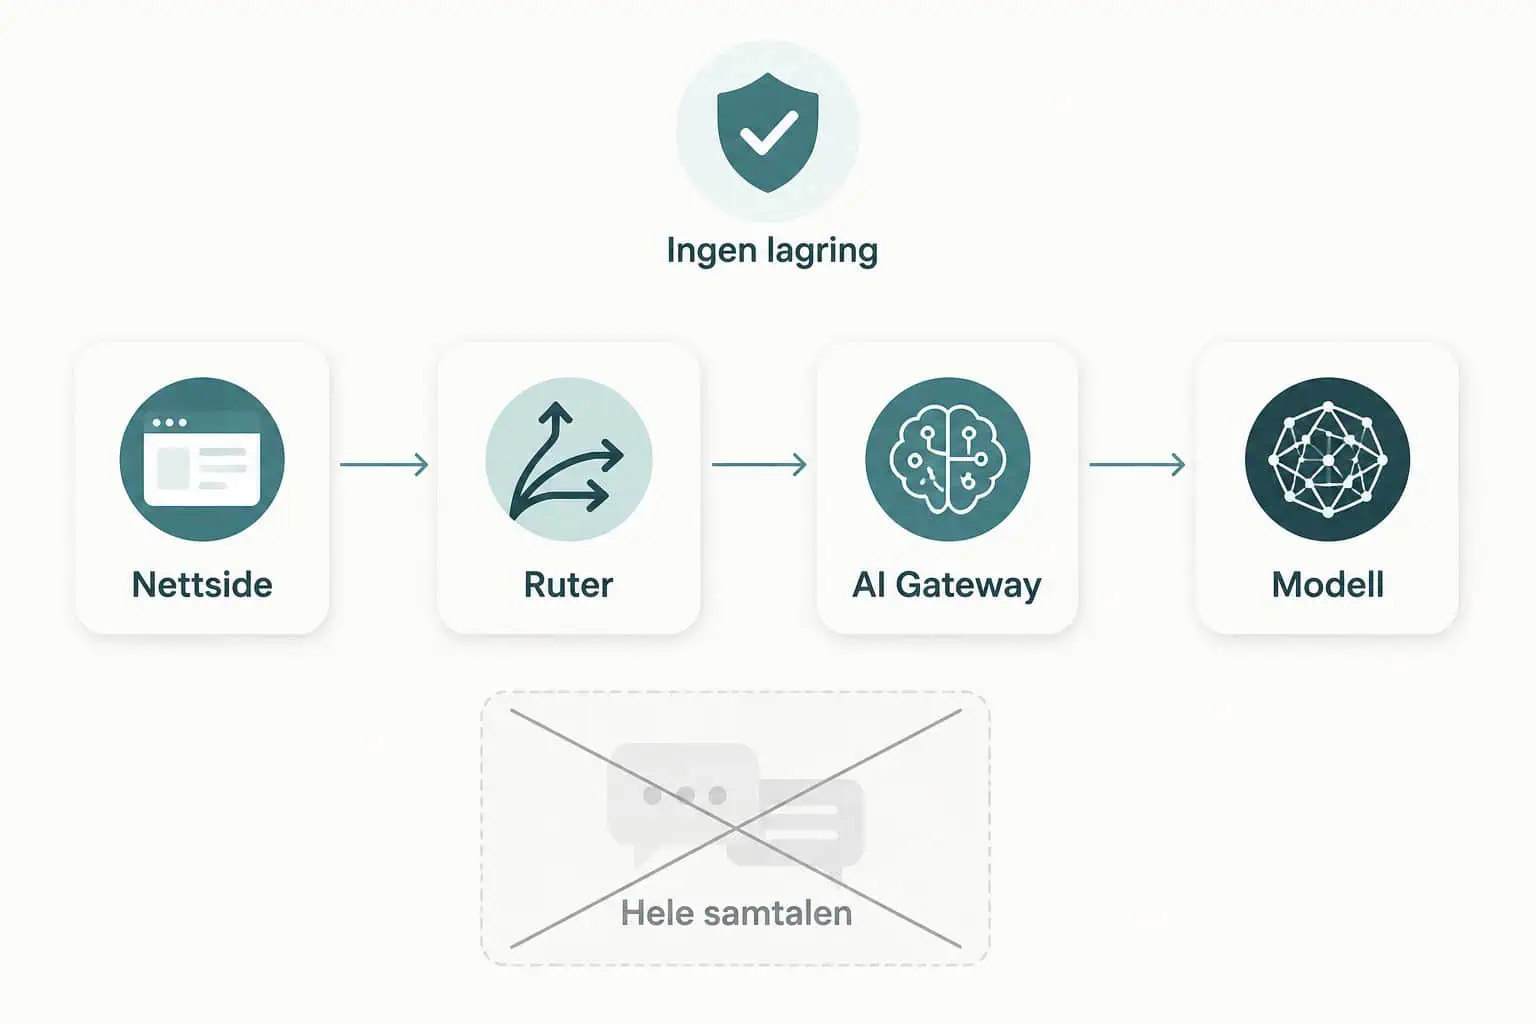
Vårt oppsett kaller Gateway med only: [«typesafe-ai»] og zero data retention, slik at forespørselen ikke rutes til andre leverandører og ikke lagres. Det som sendes er det ekstraherte spørsmålet — ikke hele samtalen, ikke sidekonteksten, og ingen nøkler. Selve spørsmålet, side-URL-en og API-nøkkelen logges ikke.
Tre punkter som endrer vurderingen når kategorien har flere leverandører:
- OpenAI Decisions tilbyr zero data retention (ZDR) og EU-datalagring for kvalifiserte kunder (OpenAI Decisions).
- TypeSafe AI kjører tjenesten på USAs vestkyst, ifølge lanseringsbloggen.
- Åpne vekter (for eksempel Perplexity pplx-decider og Laya) kan kjøres internt i EU, hvis du tar driften selv.
Det gjør ikke vurderingen for deg. Du trenger fortsatt et rettslig grunnlag, en oversikt over hvor dataene går, og en databehandleravtale som faktisk dekker leddet. Vi har skrevet om dette i GDPR for AI-agenter, og prinsippene gjelder uendret for en beslutningsmodell.
Er Jev verdt å teste for din bedrift?
Kort svar: hvis du allerede har en AI-funksjon i drift og kjenner igjen «vi kjører dyre operasjoner på spørsmål som ikke trenger dem», ja. Hvis du ikke har noe i produksjon ennå, er dette ikke stedet å begynne — begynn med selve funksjonen, og optimaliser når du har trafikk å måle på.
Vi bygde vår egen ruter på under en dag fordi vi allerede hadde chatten, loggingen og et feature-flagg på plass. Det er den rekkefølgen som gjør det billig.
Skal du vurdere det samme for din virksomhet, tar vi gjerne praten — se AI-konsulent eller ta kontakt.
Ofte stilte spørsmål
Hva er Jev, helt enkelt forklart?
Hva er Jev for en som ikke koder: en modell som tar valg i stedet for å skrive tekst. Du gir den en situasjon og et sett alternativer, og den svarer med hvilket alternativ som gjelder og hvor sikker den er.
Hva er Jev brukt til i praksis?
Ruting, triage, klassifisering og gating — avgjørelser programvaren din skal handle på. Hos oss avgjør den om et spørsmål til nettsiden trenger søk i innholdet eller kan besvares direkte.
Erstatter Jev ChatGPT eller Claude?
Nei. Den genererer ikke tekst. I vårt oppsett sitter den foran språkmodellen og bestemmer hvilken vei spørsmålet går; språkmodellen skriver fortsatt svaret.
Hva koster Jev?
TypeSafe AI oppgir 0,042 dollar per million input-tokens. Output er gratis. I praksis er beslutningskostnaden neglisjerbar sammenlignet med kallet den styrer.
Kan Jev hallusinere?
Ikke på samme måte som en språkmodell. Den velger mellom alternativer du har definert, så den kan ta feil valg — men den kan ikke finne på et svar som ikke står i settet. Se dokumentasjonen til TypeSafe for detaljene.
Hva er forskjellen på Jev og OpenAI Decisions API?
Begge returnerer typede beslutninger med sannsynligheter i stedet for tekst. Jev koster mindre per input-token og tar bare tekst. OpenAI Decisions (gpt-6-luna) tar tekst og bilder, har høyere inputpris, og tilbyr ZDR og EU-datalagring for kvalifiserte kunder.
Finnes det alternativer til Jev?
Ja. OpenAI Decisions, Liquid d1, Perplexity pplx-decider og Laya er blant alternativene. Noen har åpne vekter du kan kjøre selv. Sammenligninger som hevder å slå Jev er leverandørenes egne påstander.
Svaret genereres fra denne siden og er ikke lest av oss først.
Skal vi ta en uforpliktende prat?
Fortell oss hvor virksomheten din skal, så viser vi deg hvordan nettsiden kan ta deg dit. Du får ærlige råd, uansett om du blir kunde eller ikke.